Glänzende Objekte ohne CAD-Modell verfolgen: das Lichtfeld als Objektmodell
Mit diesem Beitrag startet unsere Reihe Lichtfeld-Forschung, gelesen für die Praxis: Bis Anfang Januar stellen wir jeden Dienstag ein aktuelles Paper zu Lichtfeldern vor, erklären verständlich, was es leistet, und ordnen ein, was es aus unserer Sicht für die industrielle Bildverarbeitung bedeutet. Die Abbildungen sind eigene Illustrationen auf Grundlage der Paper.
Wer schon einmal Bin-Picking für polierte oder verchromte Teile eingerichtet hat, kennt das Problem: Das Objekt sieht aus jedem Blickwinkel anders aus. Glanzlichter wandern über die Oberfläche, sobald sich das Teil bewegt, und mit ihnen ändern sich die Spiegelungen der Umgebung. Klassische Posenschätzung braucht entweder ein CAD-Modell oder vorab aufgenommene Referenzbilder – und beide geraten ins Straucheln, wenn Spiegelungen das Erscheinungsbild dominieren.
Nikolai Goncharov, James L. Gray und Donald G. Dansereau vom Australian Centre for Robotics (University of Sydney) schlagen einen anderen Weg vor. Ihr Argument ist einfach und aus Lichtfeldsicht elegant: Eine Lichtfeldaufnahme ist bereits ein Objektmodell. Sie erfasst die Szene aus vielen Blickwinkeln gleichzeitig und enthält damit sowohl die Geometrie als auch das blickwinkelabhängige Aussehen, das ein Tracker sonst aus Referenzansichten lernen müsste.
So funktioniert es
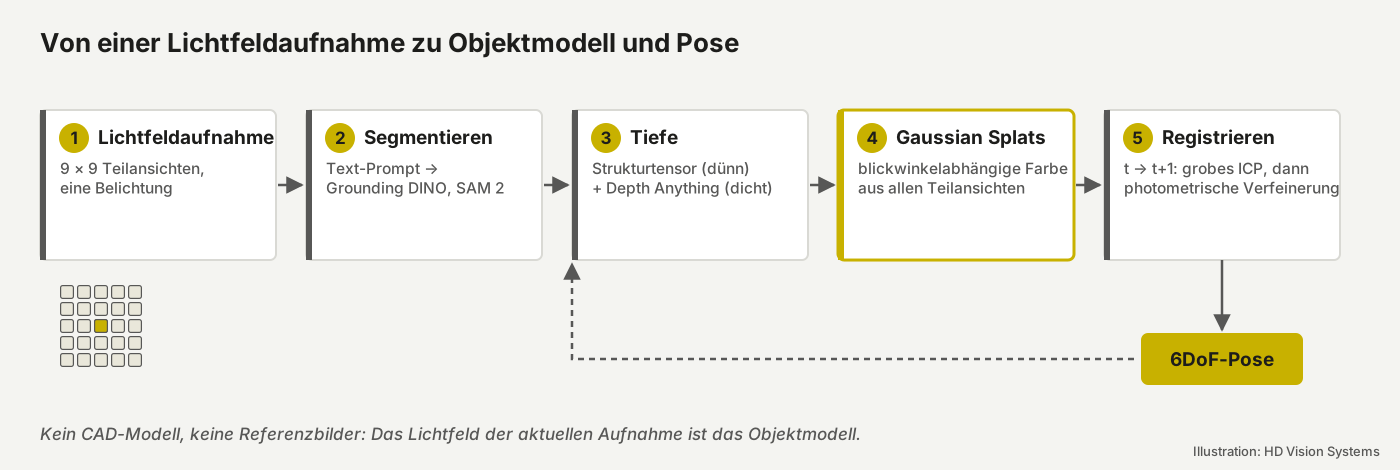
Das Verfahren baut aus jeder Lichtfeldaufnahme ein neues Objektmodell und registriert aufeinanderfolgende Modelle gegeneinander:
- Segmentierung. Das Objekt wird per Text-Prompt benannt („jug“). Grounding DINO findet es in einer Teilansicht, SAM 2 segmentiert es und überträgt die Maske auf alle Teilansichten des Lichtfelds.
- Tiefe. Eine dünne, aber verlässliche Disparitätskarte liefert der klassische Strukturtensor auf Epipolarebenenbildern. Depth Anything steuert eine dichte, aber maßstabslose Karte bei; ein linearer Fit an die dünnen Werte gibt ihr den richtigen Maßstab. Daraus wird das Objekt zur 3D-Punktwolke.
- Gaussian Splats. Jeder 3D-Punkt sammelt seine Farbe aus allen Teilansichten, in denen er sichtbar ist. Genau hier werden Spiegelungen behandelt: Die Farbe wird als blickwinkelabhängige Funktion (Kugelflächenfunktionen) gespeichert, nicht als einzelner Wert. Eine kurze Optimierung über alle Teilansichten verfeinert die Splats.
- Registrierung. Das Modell aus Aufnahme t+1 wird an das aus Aufnahme t angeglichen – zuerst grob über Merkmalszuordnung und farbiges ICP, dann, indem beide Splat-Mengen gerendert und der photometrische Fehler über alle Teilansichten minimiert wird. Ergebnis ist die relative 6DoF-Bewegung des Objekts.
Was die Ergebnisse zeigen
Die Autoren haben einen eigenen Lichtfeld-Datensatz mit 9 × 9 Teilansichten und unterschiedlich stark spiegelnden Objekten aufgenommen; die Referenzposen stammen von motorisierten Dreh- und Linearachsen. Als Vergleich dient FoundationPose im modellfreien Modus, der Referenzbilder des Objekts benötigt – das Lichtfeld-Verfahren braucht keine.
Das Bild ist eher ehrlich als triumphal. Bei einem gekippten, stark spiegelnden Krug gewinnt der Lichtfeld-Tracker deutlich: ADD 0,772 gegenüber 0,513, mittlerer absoluter Rotationsfehler 8,3° gegenüber 53,8°. Bewegt sich derselbe Krug geradlinig, ist FoundationPose besser (ADD 0,909 gegenüber 0,805), und eine Sequenz mit Bewegung entlang der Blickrichtung ist eine klare Schwäche des neuen Verfahrens. Über die aufgenommenen Sequenzen gemittelt liegen beide Ansätze ungefähr gleichauf – mit dem Unterschied, dass einer von beiden keinerlei Vorwissen über das Objekt brauchte.
Die Grenzen benennen die Autoren selbst: Schnelle, abrupte Bewegungen sind ein Problem, die Verarbeitung des Lichtfelds pro Aufnahme ist rechenaufwändig (eine Laufzeit wird nicht angegeben), und eine globale Trajektorienoptimierung fehlt noch.
Unsere Einordnung
Für die industrielle Praxis fallen drei Punkte auf.
- Spiegelungen werden zur Information. Die meisten Verfahren behandeln Glanzlichter als Störung, die unterdrückt werden muss. Wer das Aussehen je Blickrichtung speichert, macht daraus ein Merkmal – dieselbe Idee, die Lichtfeldkameras überhaupt erst robust auf glänzenden Teilen macht.
- Kein CAD, kein Einlernen. In einer Fertigungszelle ist meist ein CAD-Modell vorhanden; der eigentliche Nutzen liegt daher woanders: bei gemischten oder wechselnden Teilen, in der Logistik, bei Retouren oder bei Objekten, deren CAD-Modell nicht zum realen Teil passt (Beschichtungen, Verformungen, Toleranzen).
- Noch nicht echtzeitfähig. Ohne Laufzeitangaben und mit Foundation Models in der Schleife ist das ein Forschungsprototyp. Für taktzeitkritische Zellen erwarten wir, dass die Ideen – blickwinkelabhängiges Aussehen, Online-Modelle aus einer Lichtfeldaufnahme – zuerst als Bausteine einer Pipeline ankommen, nicht als kompletter Tracker.
Nächsten Dienstag bleiben wir bei der Tiefe: wie eine fokussierte plenoptische Kamera mit etwas Hilfe eines Foundation Models metrische Tiefe aus einer einzigen Aufnahme liefert.
Das Paper
Nikolai Goncharov, James L. Gray, Donald G. Dansereau: Light Field Based 6DoF Tracking of Previously Unobserved Objects. arXiv:2512.13007, Dezember 2025. arxiv.org/abs/2512.13007
Mehr zu den Grundlagen: Plenoptische Kameras in der Industrie und so funktioniert die Lichtfeldtechnologie.
PD Dr. Christoph Garbe
Christoph Garbe hat HD Vision Systems 2017 mitgegründet und leitet das Unternehmen. Als Privatdozent an der Universität Heidelberg (IWR) leitet er eine Forschungsgruppe für Bildverarbeitung.